LiveContext

Как связать живой разговор с памятью проекта

3 заметки · 3 мин

Как я построил LiveContext, или Как связать живой разговор с памятью проекта: иллюстрация 1

Оглавление

  1. Почему мне оказалось недостаточно просто сохранять разговоры1 мин
  2. Как LiveContext разделяет мой голос и голос собеседника1 мин
  3. LiveContext в реальном разговоревидео1 мин
  4. Почему Whisper оказался далеко не самой сложной частьюскоро
  5. Разговор — это не transcript. Это состояниескоро
  6. Как LiveContext понимает, какой контекст нужен прямо сейчасскоро
  7. Как я превратил Obsidian из архива в оперативную памятьскоро
  8. Почему я не даю LLM искать по всей базе знанийскоро
  9. Как одна реплика превращается в нужную информацию из Obsidianскоро
  10. Почему память не должна автоматически переписывать саму себяскоро

Почему мне оказалось недостаточно просто сохранять разговоры

В VoxBase я решал проблему того, что происходит после разговора.

Запись превращается в текст, текст сохраняется в Markdown, важная информация остаётся в памяти проекта. К разговору можно вернуться через день или месяц и не пытаться восстановить его по памяти.

Но довольно быстро обнаружилась другая проблема.

Иногда контекст нужен не после звонка. Он нужен прямо сейчас.

Во время разговора человек может спросить о том, что обсуждалось неделю назад. Может появиться новое возражение, измениться тема или понадобиться конкретный факт из проекта.

И нужная информация при этом уже существует: лежит в Obsidian, документах, правилах проекта, прошлых разговорах.

Проблема только в том, что искать её вручную, пока собеседник ждёт ответа, почти бессмысленно.

Так появился LiveContext.

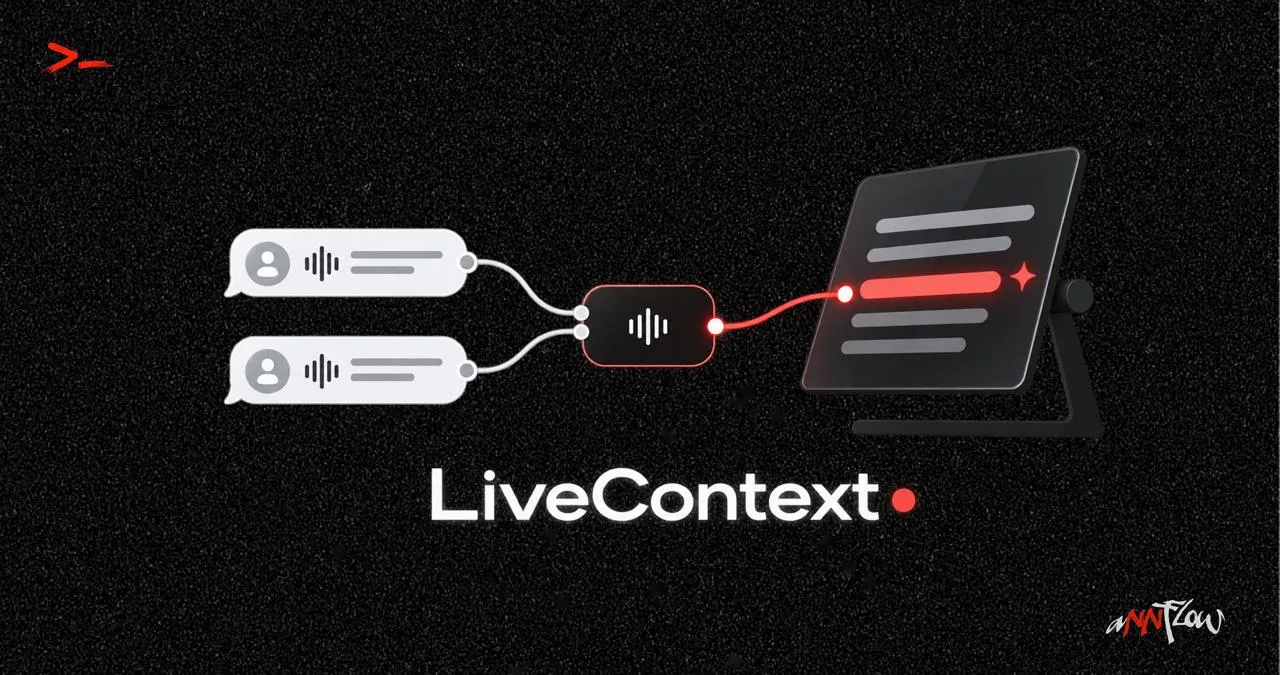
Его задача шире обычной транскрибации. Система должна получать разговор практически в реальном времени, понимать, что происходит сейчас, и связывать происходящее с контекстом конкретного проекта.

Условно:

разговор
↓
транскрибация
↓
текущее состояние разговора
↓
контекст проекта
↓
нужная информация

То есть VoxBase сохраняет разговор в память.

А LiveContext пытается сделать так, чтобы эта память могла работать еще до того, как разговор закончился

В следующих постах разберу, как я это собираю: от двух независимых аудиопотоков и локальной транскрибации до Obsidian и поиска нужного контекста во время звонка.

К оглавлению

Как LiveContext разделяет мой голос и голос собеседника

Чтобы LiveContext мог понимать разговор, сначала нужно решить довольно базовую проблему: кто именно сейчас говорит?

Можно было бы записывать весь звонок одним аудиопотоком, а потом пытаться программно определять, где мой голос, а где собеседник.

В LiveContext я пошёл другим путем: разделяю голоса ещё до транскрибации.

Получается два независимых источника:

мой микрофон → YOU

звук звонка → REMOTE

YOU приходит напрямую с физического микрофона: AirPods или USB-микрофона.

С REMOTE интереснее. Звук приложения, например Телемоста или браузера, попадает в отдельное виртуальное аудиоустройство LiveContext Remote, которое я собрал через Loopback.

То есть компьютер фактически получает две разные аудиодорожки:

микрофон ─────────────→ YOU

→ LiveContext
/
Телемост / браузер ─────→ REMOTE

У каждого потока своя обработка, свои параметры определения речи и своя очередь. И только после этого звук отправляется в локальную транскрибацию.

В результате LiveContext не приходится угадывать, кому принадлежит очередная фраза.

Он знает это из самого источника звука.

Это небольшое архитектурное решение оказалось важным для всего, что строится дальше. Потому что для системы есть большая разница между:

«клиент сказал, что цена высокая»

и

«я сказал клиенту, что цена высокая».

Текст почти одинаковый. Состояние разговора совершенно разное.

А дальше начинается более сложная часть: как превратить эти два непрерывных потока звука в достаточно быструю и точную локальную транскрибацию, не положив при этом весь компьютер.

К оглавлению

LiveContext в реальном разговоре

На видео я разбираюсь с претензией по недоставленному заказу.

LiveContext анализирует разговор в реальном времени и сразу передает его в модель вместе с актуальным контекстом проекта из Obsidian.

Поэтому модель уже знает номер заказа, претензии, сроки и историю обращений, пока разговор еще идет

К оглавлению

Следующая серияMCP-сервер