MCP-сервер

Как я построил MCP-сервер для своей рабочей системы

5 заметок · 9 мин

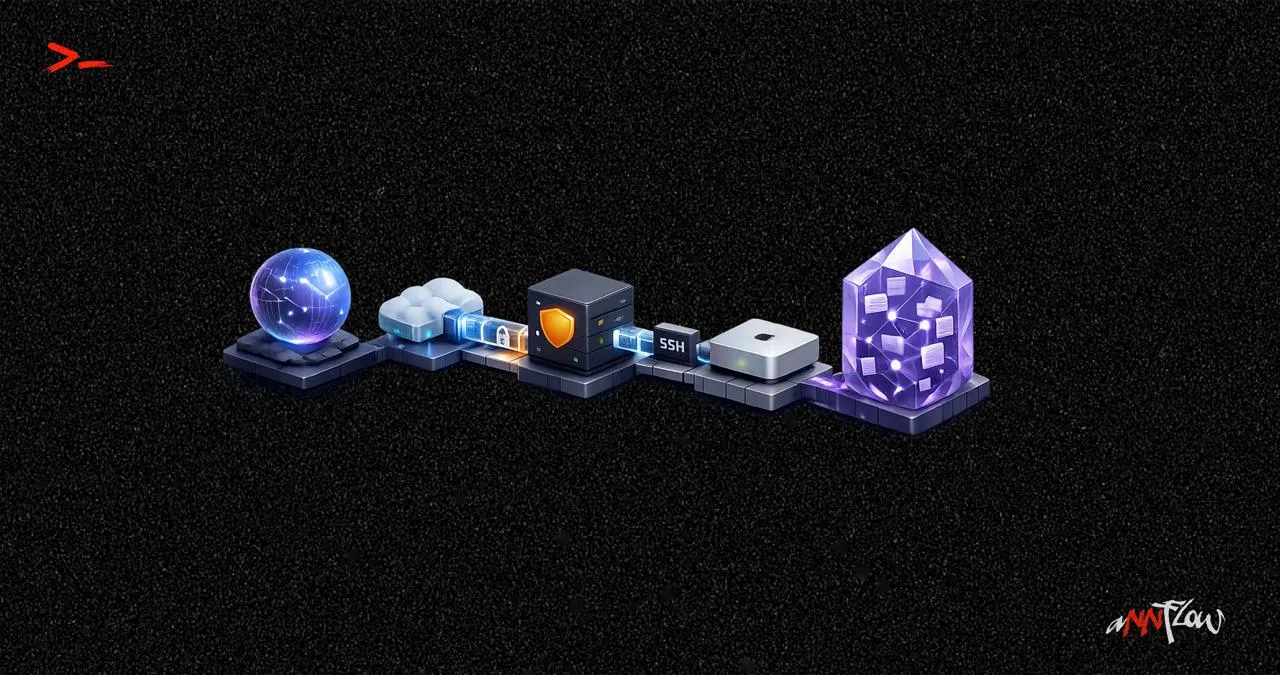
Как я построил MCP-сервер для своей рабочей системы: иллюстрация 1

Оглавление

  1. Почему я разделил память и выполнение2 мин
  2. Как LLM получила доступ к моему Obsidian2 мин
  3. Что происходит, когда LLM ищет что-то в моей памяти2 мин
  4. Как LLM добирается до локального Obsidian на моём Mac1 мин
  5. Где заканчивается MCP и что будет дальше2 мин

Почему я разделил память и выполнение

В какой-то момент количество информации, с которой я работаю, стало слишком большим.

Проекты, технические решения, задачи, схемы, заметки, промежуточные выводы.

Пока проект активен, кажется, что вся его логика находится в голове. Но стоит переключиться на другую работу и вернуться через несколько недель, часть контекста приходится восстанавливать заново.

Мне нужна была система, которая хранит не просто заметки, а состояние проекта.

Одним из первых подходов был Apple Freeform. Мне сразу подошла сама идея Canvas: раскладывать информацию пространственно, видеть связи и собирать проект не только линейным текстом.

Но довольно быстро стало понятно, что одного холста недостаточно.

Мне нужны были обычные файлы, Markdown, понятная структура каталогов, Canvas, API и возможность строить поверх всего этого собственные правила.

Так основной памятью стал Obsidian.

Но почти сразу появилась другая проблема.

В Obsidian удобно хранить архитектуру проекта, технические решения, документацию, причины изменений, планы и историю.

Но ежедневное выполнение задач удобнее держать отдельно.

Для этого у меня остался Todoist.

Сначала естественной казалась идея максимально связать две системы между собой: изменения в Obsidian отражаются в Todoist, изменения в Todoist возвращаются обратно.

На практике такая симметрия быстро создаёт новые проблемы.

Кто главный, если данные расходятся?

Что считать актуальным состоянием проекта?

Нужно ли изменение задачи переписывать обратно в документацию?

В итоге я пришёл к более простой архитектуре.

Obsidian хранит память.

Todoist управляет выполнением.

Подробное состояние проекта живёт в файлах. Например, текущий план находится в implementation_plan.md, а история важных решений сохраняется в decisions_log.md.

Todoist не пытается стать второй копией этой памяти. Он показывает то, что нужно сделать сейчас.

Из этого постепенно появилось одно из главных правил всей моей системы.

Один факт = один владелец.

Если это проектное решение, оно принадлежит проектной памяти.

Если это действие, которое нужно выполнить, оно принадлежит execution-слою.

Связь между ними остаётся, но они больше не пытаются быть зеркалами друг друга.

И здесь появился следующий вопрос.

Если реальная память проекта находится в Obsidian, как дать языковой модели доступ именно к ней, а не каждый раз вручную переносить документы в диалог?

Первым рабочим ответом на этот вопрос стал мой Obsidian MCP-сервер.

В следующем посте разберу, как через него LLM получила доступ к моему Obsidian.

К оглавлению

Как LLM получила доступ к моему Obsidian

После того как я разделил проектную память и выполнение, появилась следующая проблема.

В Obsidian уже находилась вся нужная информация о проектах: архитектура, планы реализации, технические паспорта, история решений, Canvas и связанные документы.

Но языковая модель эту память не видела.

Пока я сам не вставил нужный файл в диалог, для модели его фактически не существовало.

Можно было каждый раз вручную искать implementation_plan.md, копировать нужные заметки, добавлять связанные документы и объяснять, где сейчас находится проект.

Но тогда сама идея проектной памяти теряет значительную часть смысла.

Мне нужен был доступ к реальному Obsidian, а не очередная копия его содержимого внутри чата.

Так в системе появился MCP.

В моём случае MCP-сервер работает как интерфейс между языковой моделью и Obsidian.

Он даёт модели набор конкретных инструментов: посмотреть структуру проекта, найти заметку, выполнить поиск по vault, прочитать файл или изменить обычную заметку по прямому запросу.

При этом весь Obsidian не загружается в модель целиком.

LLM получает только инструменты, через которые может сама добраться до нужной информации.

Например, если я спрашиваю, что сейчас происходит в конкретном проекте, модели не нужно заранее передавать весь проект.

Она может найти его, открыть implementation_plan.md, при необходимости обратиться к decisions_log.md или другим связанным документам и только после этого сформировать ответ.

Технически между моделью и файлами находится ещё один слой.

MCP-сервер обращается к Obsidian через Local REST API, а уже Obsidian работает с реальным vault на моём Mac.

Получается такая цепочка:

LLM

MCP server

Obsidian Local REST API

Obsidian vault

Для меня здесь важен сам принцип.

Проектная память остаётся в файлах и продолжает быть source of truth.

LLM не хранит отдельную копию состояния проекта и не требует, чтобы я каждый раз вручную собирал для неё контекст.

Она получает возможность обратиться к памяти тогда, когда эта память действительно нужна.

Именно после этого Obsidian для меня окончательно перестал быть просто местом, где лежат заметки.

Он стал рабочей памятью, к которой можно подключать языковые модели и другие инструменты через формальный интерфейс.

Сейчас этот MCP-контур остаётся моим основным способом доступа LLM к Obsidian.

Но сам вызов инструмента скрывает довольно много интересной механики.

В следующем посте разберу, что на самом деле происходит, когда LLM ищет что-то в моей памяти: как она выбирает инструмент, как запрос проходит через MCP и почему модель не получает весь vault одним большим контекстом.

К оглавлению

Что происходит, когда LLM ищет что-то в моей памяти

В прошлом посте я рассказал, что MCP даёт языковой модели доступ к Obsidian.

Но сам доступ ещё не означает, что модель получает весь vault целиком.

Когда я задаю вопрос о проекте, система работает иначе.

Сначала LLM решает, какой инструмент ей нужен.

Например, если нужно понять текущее состояние проекта, она может сначала выполнить поиск по нужной области Obsidian.

После этого MCP возвращает не весь проект, а список подходящих файлов и фрагментов.

И только затем модель открывает те документы, которые действительно нужны для ответа.

Упрощённо получается такая цепочка:

вопрос

поиск по проекту

найденные файлы

чтение нужных документов

сбор контекста

ответ

Для меня это принципиальная часть архитектуры.

Если в vault находятся сотни проектов и тысячи файлов, передавать их модели целиком бессмысленно.

Большая часть информации не относится к текущему вопросу и только увеличивает шум.

Поэтому модель перемещается по памяти постепенно.

Например, реальный search-first протокол внутри моего MCP-контура выглядит примерно так:

searchInPath: Projects/Systems/PRJ-002 Network

query: internet OR VPN OR DNS OR MacStudio OR “Mac Studio” OR “MacBook Air” OR route OR routing OR split

Сначала задаётся область поиска.

Затем одним запросом система пытается получить достаточно широкий набор кандидатов.

После этого читаются только наиболее релевантные файлы.

Такой подход появился не только ради экономии контекста.

В какой-то момент я столкнулся с rate limit Obsidian MCP.

Если модель начинает перебирать предполагаемые названия файлов и делать много последовательных запросов, сервер может вернуть 429 и временно остановить дальнейший доступ.

Поэтому внутри проекта появился отдельный принцип:

сначала поиск, потом чтение.

Не угадывать файлы один за другим.

Не читать весь проект заранее.

Не продолжать запросы после 429.

Найти область, сделать один широкий поиск и уже из результата выбирать источники.

Технически сам MCP-клиент тоже работает через последовательность отдельных операций.

Сначала создаётся MCP-сессия.

Затем клиент получает список доступных инструментов.

После этого модель может вызывать конкретный инструмент и передавать ему параметры.

Упрощённо:

initialize

mcp-session-id

tools/list

tools/call

То есть MCP не является каналом, через который в LLM постоянно течёт весь Obsidian.

Это скорее набор дверей в проектную память.

Модель сама решает, какую дверь открыть, получает небольшой участок информации и при необходимости идёт дальше.

Именно поэтому для меня этот подход оказался удобнее ручной загрузки документов в диалог.

Я могу спросить о проекте, которым не занимался несколько недель, а модель сама найти его текущее состояние, прочитать нужные источники и восстановить контекст из реальных файлов.

Но пока мы говорили только о логике доступа.

Есть ещё один вопрос: как удалённая LLM вообще вызывает MCP-сервер, который физически работает на моём Mac?

В следующем посте разберу весь путь запроса от внешней модели до локального Obsidian.

К оглавлению

Как LLM добирается до локального Obsidian на моём Mac

Obsidian, vault и MCP-сервер работают локально на моём Mac.

Чтобы внешняя LLM могла обращаться к этой памяти, нужен отдельный транспортный слой.

Текущая схема выглядит так:

LLM / MCP-клиент

Cloudflare

VPS

reverse SSH

MCP server на Mac

Obsidian Local REST API

Obsidian vault

Публичной точкой входа служит отдельный MCP endpoint.

Cloudflare принимает запрос и передаёт его на VPS, где cloudflared направляет трафик на:

127.0.0.1:3011

Но самого MCP-сервера на VPS нет.

Порт 3011 создаётся reverse SSH-туннелем, который мой Mac поднимает самостоятельно.

Ключевой фрагмент:

-R 127.0.0.1:3011:127.0.0.1:3010

То есть всё, что приходит на 3011 внутри VPS, через SSH отправляется на локальный MCP-порт 3010 моего Mac.

Дальше запрос уже идёт внутри локальной системы:

MCP server

Obsidian Local REST API

vault

В этой архитектуре VPS остаётся только транспортным слоем.

Он не хранит vault, не индексирует заметки и не становится второй копией проектной памяти.

Даже порт 3011 доступен только внутри VPS.

Сам Obsidian остаётся локальным.

Для устойчивой работы MCP server и reverse SSH запускаются через отдельные LaunchAgent, а autossh автоматически восстанавливает туннель после обрывов.

В результате внешняя модель получает доступ к проектной памяти без переноса самой памяти в облако.

К оглавлению

Где заканчивается MCP и что будет дальше

Сейчас Obsidian MCP является рабочей частью моей системы.

Через него языковая модель может искать информацию в Obsidian, открывать заметки, собирать контекст проекта и работать с файлами.

Именно эту задачу я изначально хотел решить.

Но по мере использования стала видна следующая граница.

MCP хорошо решает задачу доступа.

Модель получает набор инструментов и сама решает, что искать, какие заметки открывать и какой контекст собирать.

Но если смотреть дальше, мне нужна уже не просто возможность обратиться к файлам.

Мне нужна отдельная система, которая сама понимает устройство моей проектной памяти.

Поэтому следующим этапом стал Obsidian Knowledge Agent.

Сейчас этот проект находится в активной разработке.

Если очень сильно упростить разницу, то MCP выглядит примерно так:

LLM обращается к Obsidian через инструменты и сама собирает нужный контекст.

Knowledge Agent должен работать иначе.

У него появляется собственный слой поиска и индексации, понимание структуры проектов, связей между файлами и Canvas, правил источников и границ проекта.

То есть перед моделью будет находиться отдельная система, которая сначала определяет, где искать, что относится к вопросу и какой контекст действительно нужно передать дальше.

Меняется и работа с изменениями.

В MCP доступ к заметке и возможность её изменить находятся довольно близко друг к другу.

В Knowledge Agent чтение, рассуждение и изменение состояния разделяются.

Найти информацию можно одним контуром.

Предложить изменение другим.

А реально изменить проект только через отдельный контролируемый механизм с правилами безопасности.

В результате меняется сама роль MCP.

Он не исчезает.

Но из центра архитектуры превращается в один из способов подключения к системе.

Если текущую архитектуру можно описать так:

LLM → MCP → Obsidian

то следующая постепенно становится такой:

LLM → Knowledge Agent → проектная память

Где под проектной памятью находятся уже не только Markdown-файлы, но структура проектов, Canvas, связанные источники, собственный индекс и правила работы со всем этим.

Часть этой архитектуры уже реализована, часть ещё строится.

Поэтому подробно расскажу про Obsidian Knowledge Agent позже.

А эту серию на этом можно закончить.

MCP стал первым рабочим мостом между LLM и моей памятью.

Следующий этап заключается уже не в том, чтобы дать модели доступ к знаниям.

А в том, чтобы построить систему, которая умеет с этими знаниями работать.

К оглавлению

Следующая серияVoxBase