VoxBase

Как превратить голос, видео и подкасты в память

8 заметок · 14 мин

Как я построил VoxBase, или Как превратить голос, видео и подкасты в память: иллюстрация 1

Оглавление

  1. Почему голосовые заметки обычно умирают2 мин
  2. Как VoxBase превращает запись с iPhone в Markdownфото2 мин
  3. Почему Whisper здесь не главное: VAD, chunks и подготовка аудиофото2 мин
  4. Сигнальный тракт: как звук готовится к распознаванию1 мин
  5. Почему VoxBase работает локально и самостоятельнофото2 мин
  6. Voice Reference: как система понимает, где мой голос2 мин
  7. ClipMind: как TikTok, YouTube и Apple Podcasts превращаются в Markdownфото2 мин
  8. Серия про VoxBase закончилась1 мин

Почему голосовые заметки обычно умирают

У меня давно появилась простая, но неприятная проблема: после переговоров, встреч и обсуждений остается слишком много нюансов, которые нельзя нормально удержать в голове.

На самой встрече все кажется ясным.

  • Клиент что-то уточнил.
  • Где-то изменился смысл.
  • Где-то прозвучала важная формулировка.
  • Где-то стало понятно, что человеку на самом деле нужно.
  • Где-то появилась маленькая деталь, из которой потом может вырасти задача, решение или отдельный проект.

А потом встреча заканчивается.

И начинается обычная потеря контекста.

Можно включить диктофон на iPhone.
Но аудиофайл сам по себе почти ничего не решает.
Проблема в том, чтобы звук быстро стал рабочим текстом.

Мне нужно было получать транскрибацию примерно в течение 10 минут после разговора.

Не через отдельный сервис, в который надо идти, загружать файл, ждать, проверять, выгружать результат.

Мне нужен был нормальный путь:

разговор
› запись
› транскрипт
› текстовый артефакт
› дальнейшая работа

Встроенные решения на телефоне для этой задачи меня не устраивали.

Качество, стабильность, контроль, формат результата, дальнейшая обработка, все это быстро упирается в ограничения.

Телефон удобен как точка записи, но не как полноценная фабрика обработки речи.

Вообще, существует отдельный класс устройств, которые записывают тебя весь день и автоматически делают расшифровки. Идея понятная: повесил маленький рекордер, он слушает, потом сервис превращает день в текст. Но мне не хотелось покупать отдельное устройство, платить за подписку и отдавать всю эту логику внешней системе.

Я давно для себя решил: если это становится частью моей памяти, рабочего процесса и личной инфраструктуры, я хочу понимать, как это устроено.

Так появился VoxBase.

Сначала это был ответ на очень прикладную потребность: автоматически превращать записи с iPhone в транскрипты.

Но довольно быстро стало понятно, что задача шире.

Речь идет не только про диктофон.

  • Есть голосовые заметки.
  • Есть переговоры.
  • Есть YouTube.
  • Есть TikTok.
  • Есть подкасты.
  • Есть длинные обсуждения, из которых нужно вытаскивать смысл, решения и следующие шаги.

Все это разные источники, но у них одна общая проблема:

важная информация часто приходит в виде звука или видео, а моя рабочая система живет в тексте.

Сначала запись попадает с iPhone на Mac.
Потом система сама подхватывает файл.
Потом аудио проходит обработку.
Потом появляется Markdown.
Потом этот текст уже можно читать, искать, отдавать LLM, превращать в задачи, посты, заметки и решения.

Это первый слой.

Дальше из этой идеи выросли другие ветки: транскрибация YouTube, TikTok, Apple Podcasts и следующий проект, LiveContext, где речь уже идет не о расшифровке после разговора, а о транскрибации в реальном времени, пока разговор еще идет.

Но начиналось все с простой вещи.

Я понял, что после важных разговоров мне нужен не аудиофайл.

Мне нужна память.
К оглавлению

Как VoxBase превращает запись с iPhone в Markdown

VoxBase я сделал, как конвейер, где у каждого слоя есть своя задача:

iPhone
› iCloud
› Mac worker
› VAD
› chunks
› Whisper
› Markdown + metadata

Я записываю голос на iPhone через Just Press Record.

Файл появляется в iCloud, но VoxBase не обрабатывает его сразу.

Сначала система проверяет, что запись действительно готова:

  • файл уже не .icloud
  • размер перестал меняться
  • запись ещё не обработана
  • worker не запущен второй раз
  • оригинал можно безопасно читать

Упрощённо логика выглядит так:

for file in iphone_recordings:
    if not file.ready():
        continue

    if file in processed:
        continue

    copy = make_working_copy(file)

    speech = detect_speech(copy)
    chunks = build_chunks(speech, target_sec=60)

    text = transcribe(chunks)

    write_markdown(text)
    write_metadata(file, speech, chunks)

    archive_original(file)
    mark_processed(file)

file.ready() проверяет, что iCloud уже полностью синхронизировал запись
• processed защищает от повторной обработки одного и того же файла
• make_working_copy() создаёт копию, чтобы не трогать оригинал
• detect_speech() ищет в аудио именно речь
• build_chunks() собирает речевые участки в блоки примерно по 60 секунд
• transcribe() отправляет эти блоки в Whisper
• write_markdown() создаёт итоговый .md файл
• write_metadata() сохраняет техническую информацию о транскрипции
• archive_original() кладёт исходный .m4a в архив
• mark_processed() помечает запись как уже обработанную

Главный принцип: оригинал не трогается.

Исходный .m4a не режется, не чистится и не перезаписывается. VoxBase работает с копией.

Самый важный слой здесь не Whisper, а подготовка до Whisper.

Система не отправляет весь аудиофайл целиком.

Сначала она ищет речь.

Для этого используется VAD, Voice Activity Detection.

длинная запись
› карта речи
› чанки по ~60 секунд
› Whisper

Так VoxBase не транскрибирует пустоту и не кормит модель мусором.

Потом каждый chunk приводится через ffmpeg к рабочему виду:

  • mono
  • 16 kHz
  • denoise
  • loudnorm
  • WAV для Whisper

После этого локальный whisper-cli с моделью large-v3 превращает речь в текст.

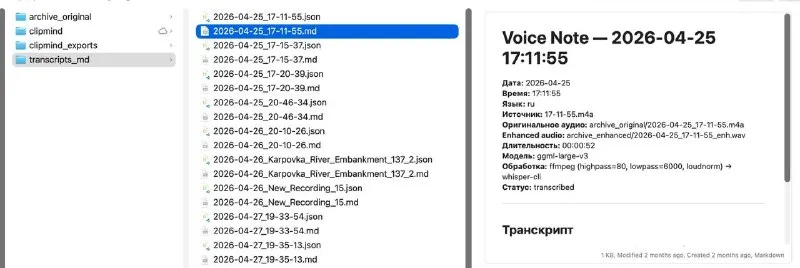
На выходе появляется Markdown и metadata:

  • исходный файл
  • длительность записи
  • сколько было речи
  • сколько тишины пропущено
  • сколько chunks получилось
  • какая модель использовалась
  • какой pipeline сработал

То есть результатом становится не просто расшифровка.

Появляется текстовый артефакт с происхождением.

голос
› речь
› chunks
› транскрипт
› Markdown
› память

Раньше запись с iPhone была концом процесса.

Теперь она стала входом в систему.

В следующем посте расскажу, почему я решил делать этот pipeline локальным, а не через облачный транскрибатор.

Запись с iPhone. Через несколько минут рядом с оригинальным .m4a появляются Markdown и metadata.

К оглавлению

Почему Whisper здесь не главное: VAD, chunks и подготовка аудио

Обычно транскрибацию описывают так:

аудио
› Whisper
› текст

Но качество часто определяется раньше, чем запускается Whisper.

Главный вопрос:

что именно мы отправляем модели?

В записи может быть час звука, но далеко не час речи.

Паузы.
Ожидание.
Фоновый шум.
Случайные звуки.
Длинные участки, где никто ничего не говорит.

Если отправить всё целиком, модель тратит время на пустоту, теряет контекст и иногда начинает находить слова там, где их не было.

Поэтому VoxBase сначала строит карту речи.

аудио
› Silero VAD
› речевые острова
› chunks
› Whisper

VAD, Voice Activity Detection, не распознаёт слова, он отвечает на более простой вопрос:
где человек говорит, а где нет?

segments = detect_speech(audio)
chunks = merge_segments(segments, target_sec=60)

for chunk in chunks:
    text = whisper(chunk)
  • detect_speech() находит начало и конец каждого речевого участка
  • merge_segments() собирает мелкие участки примерно в минутные блоки
  • только после этого каждый блок отправляется в Whisper

Почему не транскрибировать каждый короткий сегмент отдельно?

Потому что на фрагментах по 1–2 секунды Whisper теряет контекст и начинает галлюцинировать.

Поэтому VoxBase собирает мелкие реплики в chunks примерно по 60 секунд речи.

Не весь файл целиком.
Не отдельные обрывки.
А достаточно большие блоки, чтобы модель понимала контекст.

На одном тесте запись длиной 26 минут содержала 131 речевой сегмент. VoxBase собрал их всего в 4 нормальных chunk.

На другом тесте:

62 минуты аудио
› 574 речевых сегмента
› 42:50 реальной речи
› 30,9% тишины пропущено

То есть почти треть файла вообще не пришлось транскрибировать.

Перед Whisper каждый chunk дополнительно проходит через ffmpeg:

  • переводится в mono
  • приводится к 16 kHz
  • очищается от части шума
  • нормализуется по громкости
  • сохраняется как рабочий WAV

И только после этого включается локальная модель large-v3.

Главная мысль оказалась простой:

хорошая транскрибация начинается не с выбора модели.
Она начинается с того, что модель не заставляют слушать мусор.

VoxBase сначала отделяет речь от звука, восстанавливает удобный контекст и только потом просит Whisper распознать слова.

сырой звук
› карта речи
› чистые chunks
› Whisper
› транскрипт с исходными таймкодами

Поэтому Whisper здесь важен, но он лишь последний рабочий на конвейере.

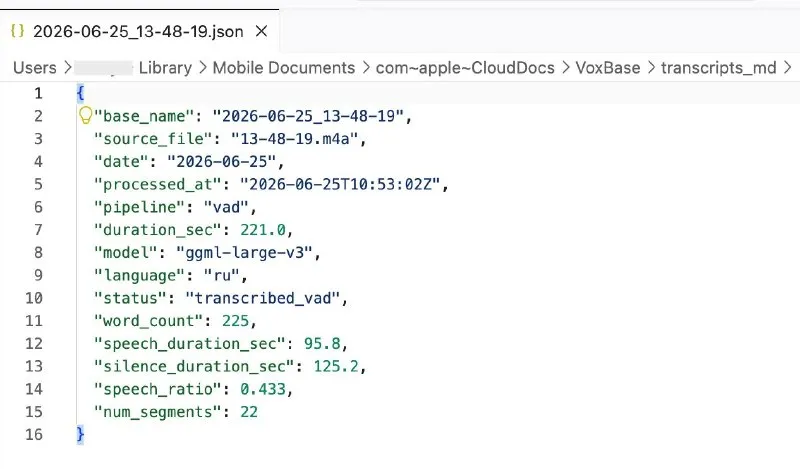
Один из metadata-файлов VoxBase. Из 221 секунды записи только 95,8 секунды оказались речью

К оглавлению

Сигнальный тракт: как звук готовится к распознаванию

Перед Whisper каждый речевой фрагмент проходит через ffmpeg:

-af "highpass=f=80,lowpass=f=6000,afftdn=nf=-20,acompressor=threshold=-25dB:ratio=4:attack=5:release=50,loudnorm" \
-ac 1 -ar 16000
  • highpass=80 срезает гул, вибрации и лишний низ
  • lowpass=6000 убирает верхнечастотное шипение
  • afftdn подавляет постоянный фоновый шум
  • acompressor выравнивает тихие и громкие фразы
  • ratio=4 сжимает пики примерно в пропорции 4:1
  • attack=5 быстро реагирует на резкие звуки
  • release=50 плавно возвращает уровень
  • loudnorm нормализует итоговую громкость
  • mono, 16 kHz приводит запись к формату Whisper

Здесь легко перестараться.

Сильное шумоподавление вместе с фоном начинает удалять окончания слов. Компрессия может поднять шум, а noise gate способен отрезать тихую речь.

Поэтому основной режим очищает запись, но старается не разрушить голос.

Для сложных условий предусмотрен более жёсткий Noisy preset.

В результате Whisper получает не исходную запись с iPhone, а подготовленный сигнал с более ровной громкостью и меньшим количеством фонового шума.

К оглавлению

Почему VoxBase работает локально и самостоятельно

В VoxBase iCloud не является мозгом системы.

Он работает курьером.

iPhone
› iCloud переносит запись
› Mac обрабатывает её локально
› Markdown возвращается в iCloud

Саму транскрибацию выполняет мой Mac:

  • Silero VAD находит речь
  • ffmpeg подготавливает аудио
  • whisper-cli запускает модель large-v3
  • Metal GPU ускоряет обработку
  • внешний API для транскрибации не нужен

Нет оплаты за минуты.
Нет лимита запросов.
Нет необходимости отправлять разговор стороннему сервису.

Но локальность сама по себе ничего не решает, если каждый файл приходится запускать руками.

Поэтому VoxBase работает через launchd, системный планировщик macOS.

В конфигурации worker есть простая логика:

<key>StartInterval</key>

<integer>60</integer>

Это означает: примерно раз в минуту macOS запускает проверку новых записей.

Worker смотрит:

  • полностью ли файл скачался из iCloud
  • перестал ли меняться его размер
  • не был ли он обработан раньше
  • не работает ли уже другой экземпляр
  • можно ли безопасно начать транскрибацию

Если все готово, начинается pipeline.

Если нет, файл просто ждет следующей проверки.

Я отдельно проверял сценарии с разрывами:

iPhone без интернета
› появился Wi-Fi
› запись синхронизировалась
› VoxBase сделал транскрипт

И другой вариант:

worker остановлен
› записи накапливаются
› worker запускается
› очередь обрабатывается

То есть система не требует идеального момента, когда одновременно доступны iPhone, интернет и Mac, она продолжает работу, когда условия снова становятся нормальными.

Еще одно важное решение появилось после проблем с CloudKit.

Сначала часть рабочих файлов тоже находилась в iCloud. Но chunks, временное аудио, логи и постоянно меняющийся state начали раздувать локальный кэш облака.

После этого архитектура стала жестче.

В iCloud:

  • готовые Markdown-транскрипты
  • metadata
  • постоянные копии оригиналов

Локально на Mac:

  • временная обработка
  • chunks
  • логи
  • state
  • ошибки
  • locks и cache

Правило получилось простым:

iCloud должен хранить артефакты, а не внутренности работающей машины.

Отдельный агент ночью удаляет временные улучшенные аудиофайлы. Оригиналы при этом не удаляются никогда.

В итоге роли разделены:

iCloud переносит
› launchd следит
› Mac обрабатывает
› Markdown сохраняет результат

VoxBase работает самостоятельно не потому, что в нём много AI.

А потому, что обычные системные детали собраны в устойчивый цикл: проверить, обработать, сохранить, не повторить и очистить временное.

В следующем посте расскажу про следующий слой: как система может определить не только что было сказано, но и где именно говорю я.

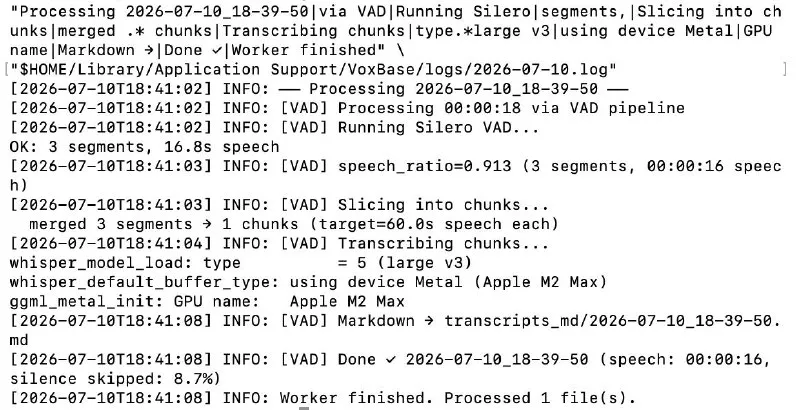
Один рабочий цикл VoxBase Новая запись найдена, речь выделена, Whisper запущен локально, Markdown создан автоматически.

К оглавлению

Voice Reference: как система понимает, где мой голос

Whisper может понять, что сказано.

Но сам по себе он не знает, кто это сказал.

Даже если система разделит разговор на:

SPEAKER_00
SPEAKER_01
SPEAKER_02

она все еще не понимает, где среди них я.

Для этого в VoxBase спроектирован отдельный слой: Voice Reference.

Его задача:

разделить говорящих
› сравнить каждый голос с моим эталоном
› пометить Me / Other

Сначала я записал несколько образцов своего голоса:

  • iPhone
  • микрофон Mac
  • разные условия записи
  • по 1–3 минуты речи

Из этих записей система создает не текст и не аудиокопию, а voice embedding. Это числовой отпечаток голоса.

reference = embed(my_voice)

for speaker in speakers:
    score = similarity(embed(speaker), reference)

me = speaker_with_highest_score
  • embed() превращает голос в набор числовых признаков
  • similarity() сравнивает каждый найденный голос с моим референсом
  • голос с наибольшим совпадением получает метку Me
  • остальные становятся Other

Полный pipeline выглядит так:

запись разговора
› pyannote делит её по говорящим
› SpeechBrain создаёт embeddings
› VoxBase сравнивает их с моим голосом
› Whisper добавляет текст

На выходе может появиться уже не безличная стенограмма:

[00:00:04] Speaker 1: Значит, я хочу понять...
[00:00:09] Speaker 2: Да, давай посмотрим.

А нормальный разговор:

[00:00:04] Me: Значит, я хочу понять...
[00:00:09] Other: Да, давай посмотрим.

При этом система не должна притворяться, что уверена всегда.

В metadata сохраняется score совпадения:

  • высокий › уверенное совпадение
  • средний › Me, но с предупреждением
  • низкий › best guess и low confidence

Это важный принцип VoxBase: не скрывать неопределенность, а сохранять ее вместе с результатом.

Voice Reference добавляет новый уровень.

Сначала VoxBase научился понимать:

где есть речь

Потом:

что было сказано

Следующий шаг:

кто именно это сказал

И здесь транскрипт начинает сохранять структуру разговора.

В следующем посте расскажу, как из VoxBase вырос ClipMind: слой, который превращает TikTok, YouTube и подкасты в такие же текстовые артефакты.

К оглавлению

ClipMind: как TikTok, YouTube и Apple Podcasts превращаются в Markdown

После голосовых заметок у VoxBase появился второй вход.

Не мой голос, а чужие медиа.

Я отправляю ссылку с iPhone через Share Sheet.

Дальше ClipMind сам определяет источник:

if is_tiktok(url):
    process_tiktok(url)
elif is_youtube(url):
    process_youtube(url)
elif is_apple_podcast(url):
    process_podcast(url)

То есть одна очередь принимает разные ссылки, но внутри запускает разные стратегии.

Потому что TikTok, YouTube и подкаст нельзя обрабатывать одинаково.

TikTok

Сначала ClipMind ищет captions и проверяет:

  • тот ли язык
  • достаточно ли текста
  • не lyrics ли это
  • не мусорные ли автосубтитры

Если captions не проходят проверку:

видео
› аудио
› ffmpeg
› локальный Whisper
› Markdown

YouTube

Здесь принцип другой:

не скачивать видео, если текст уже существует.

YouTube URL
› metadata
› готовый transcript
› Markdown

Никакого видео, аудио и Whisper, если субтитры доступны.

Если их нет, ClipMind не начинает тяжелую загрузку вслепую. Он сохраняет metadata и понятный статус ошибки.

Apple Podcasts

Это самый сложный источник.

Apple Podcasts URL
› iTunes Lookup
› RSS
› готовый transcript

Если текста в RSS нет:

RSS audio enclosure
› локальная транскрибация

Но длинный подкаст нельзя незаметно отправить в Whisper фоном. Однажды такой fallback создал лишнюю нагрузку на GPU, поэтому теперь он отключён для автоматической очереди и запускается только явно.

Самая важная часть ClipMind начинается еще до транскрипции.

Как только ссылка попадает в очередь, создаётся задача в Todoist.

Даже если обработка позже завершится ошибкой.

  • исходная ссылка не теряется
  • одна задача обновляется по мере обработки
  • дубли не создаются
  • после завершения ссылка удаляется из очереди
  • временные видео, аудио и chunks очищаются
  • в iCloud остаются только лёгкие финальные артефакты

В итоге три совершенно разных источника сходятся в одной форме:

ссылка
› правильная стратегия извлечения
› Markdown
› Todoist
› память

Главная идея ClipMind оказалась не в том, чтобы транскрибировать все подряд.

А в том, чтобы сначала найти самый дешёвый и точный путь к тексту.

Иногда это готовые субтитры.
Иногда RSS.
Иногда локальный Whisper.
Иногда честный failure artifact.

Разные входы.
Разные маршруты.
Один результат: медиа перестает исчезать в ленте и становится частью моей рабочей системы.

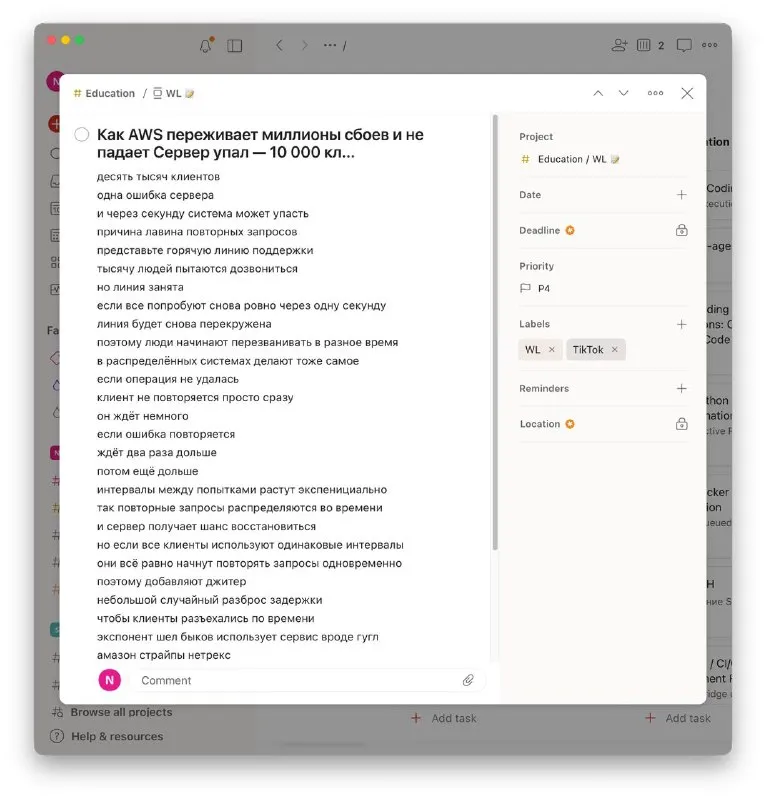
Ссылка из TikTok попадает в Todoist и превращается в текст, с которым уже можно работать

К оглавлению

Серия про VoxBase закончилась

Я рассказал, как голосовые заметки, TikTok, YouTube и подкасты превращаются в Markdown и становятся частью моей рабочей памяти.

Но сама память состоит не только из транскриптов.

Еще нужна система, которая умеет хранить контекст, связи между заметками, проектами и решениями.

Поэтому следующие посты будут про мой MCP-сервер для Obsidian и про то, как языковые модели получают доступ к знаниям внутри моей базы.

А потом я вернусь к теме транскрибации.

Потому что следующий шаг оказался гораздо интереснее.

Если VoxBase работает после разговора, то LiveContext работает во время разговора.

Но это уже совсем другая история, скоро расскажу 💻

К оглавлению

Следующая серияАвтоотклики