Как VoxBase превращает запись с iPhone в Markdown
VoxBase я сделал, как конвейер, где у каждого слоя есть своя задача:
iPhone
› iCloud
› Mac worker
› VAD
› chunks
› Whisper
› Markdown + metadata
Я записываю голос на iPhone через Just Press Record.
Файл появляется в iCloud, но VoxBase не обрабатывает его сразу.
Сначала система проверяет, что запись действительно готова:
- файл уже не .icloud
- размер перестал меняться
- запись ещё не обработана
- worker не запущен второй раз
- оригинал можно безопасно читать
Упрощённо логика выглядит так:
for file in iphone_recordings:
    if not file.ready():
        continue

    if file in processed:
        continue

    copy = make_working_copy(file)

    speech = detect_speech(copy)
    chunks = build_chunks(speech, target_sec=60)

    text = transcribe(chunks)

    write_markdown(text)
    write_metadata(file, speech, chunks)

    archive_original(file)
    mark_processed(file)
file.ready() проверяет, что iCloud уже полностью синхронизировал запись
• processed защищает от повторной обработки одного и того же файла
• make_working_copy() создаёт копию, чтобы не трогать оригинал
• detect_speech() ищет в аудио именно речь
• build_chunks() собирает речевые участки в блоки примерно по 60 секунд
• transcribe() отправляет эти блоки в Whisper
• write_markdown() создаёт итоговый .md файл
• write_metadata() сохраняет техническую информацию о транскрипции
• archive_original() кладёт исходный .m4a в архив
• mark_processed() помечает запись как уже обработанную
Главный принцип: оригинал не трогается.
Исходный .m4a не режется, не чистится и не перезаписывается. VoxBase работает с копией.
Самый важный слой здесь не Whisper, а подготовка до Whisper.
Система не отправляет весь аудиофайл целиком.
Сначала она ищет речь.
Для этого используется VAD, Voice Activity Detection.
длинная запись
› карта речи
› чанки по ~60 секунд
› Whisper
Так VoxBase не транскрибирует пустоту и не кормит модель мусором.
Потом каждый chunk приводится через ffmpeg к рабочему виду:
- mono
- 16 kHz
- denoise
- loudnorm
- WAV для Whisper
После этого локальный whisper-cli с моделью large-v3 превращает речь в текст.
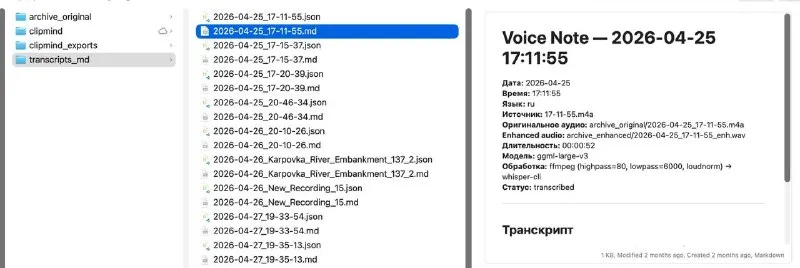
На выходе появляется Markdown и metadata:
- исходный файл
- длительность записи
- сколько было речи
- сколько тишины пропущено
- сколько chunks получилось
- какая модель использовалась
- какой pipeline сработал
То есть результатом становится не просто расшифровка.
Появляется текстовый артефакт с происхождением.
голос
› речь
› chunks
› транскрипт
› Markdown
› память
Раньше запись с iPhone была концом процесса.
Теперь она стала входом в систему.
В следующем посте расскажу, почему я решил делать этот pipeline локальным, а не через облачный транскрибатор.